
مدل تصمیمگیری چندوجهی d3-ultra با ۲۷ میلیارد پارامتر عرضه شد
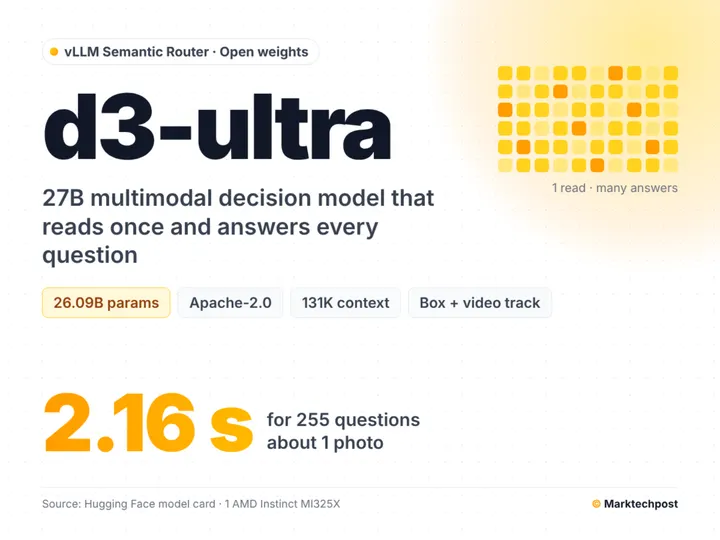
تیم vLLM Semantic Router مدل تصمیمگیری چندوجهی جدیدی به نام d3-ultra با ۲۷ میلیارد پارامتر منتشر کرده است. این مدل متن تولید نمیکند، بلکه با یک بار خواندن ورودی، احتمال پاسخها را برای متن، تصویر و ویدیو محاسبه میکند.
مدل d3-ultra به عنوان جدیدترین عضو خانواده تصمیم ۳.۰ تحت مجوز Apache-2.0 عرضه شده است. این مدل با داشتن ۲۶.۰۹ میلیارد پارامتر متراکم و پشتیبانی از زمینه ۱۳۱,۰۷۲ توکن، برای کارهایی نظیر مسیریابی، طبقهبندی، جانمایی بصری و بررسی ویدیو طراحی شده است. برخلاف مدلهای زبانی رایج، d3-ultra متنی تولید نمیکند، بلکه ورودی را یک بار میخواند و برای هر سوال احتمالات پاسخ را بازمیگرداند.
این مدل از معماری مبتنی بر Qwen3.5 استفاده میکند و در آزمونهای داخلی SR-Text توانسته است امتیاز بالای ۸۷.۲ را کسب کند که بالاتر از مدلهای رقیب قرار دارد. این سیستم میتواند سوالات چندگزینهای، بله/خیر، رتبهبندی و تعیین محدوده در تصاویر را پردازش کند. زمان پاسخگویی این مدل روی پردازندههای گرافیکی مناسب بسیار سریع است و میتوان آن را از طریق کتابخانههای ترنسفورمرز، موتور اختصاصی vLLM Semantic Router و رابطهای API به کار گرفت.
گزارش فارسی این خبر با کمک هوش مصنوعی و فقط بر اساس اطلاعات منتشرشده در منبع تهیه شده است.