
بایدو مدل متنباز Unlimited OCR 2 را برای پردازش اسناد صدصفحهای عرضه کرد
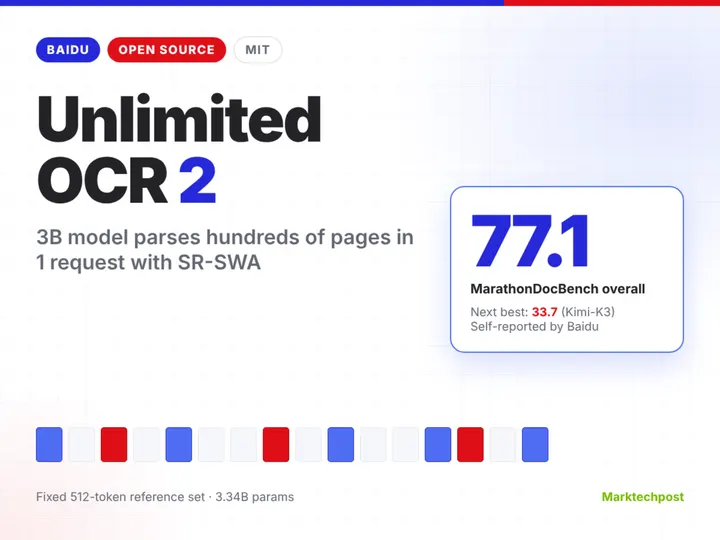
شرکت بایدو مدل تشخیص نوری حروف Unlimited OCR 2 را با ۳.۳ میلیارد پارامتر تحت مجوز MIT منتشر کرد. این مدل با استفاده از مکانیزم توجه پراکنده، امکان پردازش اسناد حجیم صدصفحهای را در یک درخواست فراهم میکند.
بایدو مدل جدیدی به نام Unlimited OCR 2 را برای پردازش اسناد بسیار طولانی منتشر کرده است. این مدل ۳.۳ میلیارد پارامتری قادر است کتابها، پروندهها و گزارشهای صدصفحهای را در یک درخواست واحد پردازش کرده و متون، جداول، فرمولها و ساختار سرتیترها را استخراج کند. هسته اصلی این مدل بر پایه مکانیزم توجه پیشرفتهای به نام SR-SWA کار میکند که هزینههای رمزگشایی را در طول پردازش اسناد طولانی ثابت نگه میدارد.
در بنچمارکهای ارائهشده، این مدل توانسته است امتیازات بالایی در ارزیابیهای مربوط به اسناد چندصفحهای و طولانی کسب کند و عملکرد بهتری نسبت به سایر مدلهای رقیب در مستندات حجیم داشته باشد. وزنهای این مدل تحت مجوز MIT در گیتهاب قرار گرفته و از طریق کتابخانههای استاندارد و ابزارهای سرویسدهی قابل اجراست.
گزارش فارسی این خبر با کمک هوش مصنوعی و فقط بر اساس اطلاعات منتشرشده در منبع تهیه شده است.