
چگونه شخصیسازی واژهنامه مدلهای زبانی کوچک هزینه استنتاج را تا ۷۷ درصد کاهش میدهد
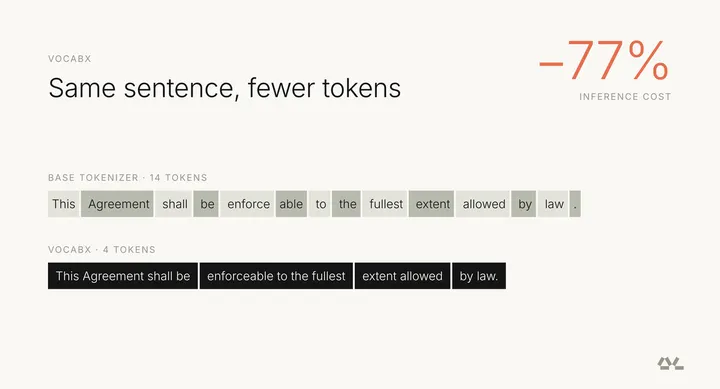
پژوهشگران با روشی به نام VocabX نشان دادهاند که بهینهسازی واژهنامه مدلهای زبانی کوچک برای حوزههای خاص میتواند هزینههای استنتاج را به میزان چشمگیری کاهش دهد. این روش با حذف نشانههای اضافی و بهرهگیری از الگوهای تکرارپذیر، ضمن حفظ کیفیت، کارایی مدل را در پردازش وظایف مشخص بهبود میبخشد.
مدلهای زبانی کوچک که برای یک حوزه یا وظیفه خاص از طریق تنظیم دقیق مدلهای متنباز عمومی مانند Qwen و Gemma توسعه مییابند، معمولاً واژهنامهای را به ارث میبرند که برای کاربردهای عمومی و دامنههای گوناگون طراحی شده است. این واژهنامه عمومی دو نوع ضایعات ایجاد میکند؛ نخست تکهتکه شدن متنهای تکرارپذیر حوزه خاص به نشانههای متعدد و دوم وجود دهها هزار ورودی در واژهنامه که هرگز در آن حوزه استفاده نمیشوند اما مدل در هر مرحله تولید، امتیاز آنها را محاسبه میکند. پژوهشگران در مقاله جدیدی به نام VocabX روشی را بررسی کردهاند که واژهنامه را بر اساس هزینه هر نشانه به جای بسامد آن سفارشیسازی میکند.
در سیستمهایی مانند ارزیاب خودکار مقالات که بر پایه مدل Qwen3-4B اجرا میشود، واژهنامه پیشفرض باعث میشود متنهای تولیدی مدل به نشانههای بسیار بیشتری نیاز داشته باشند. از آنجا که تولید هر نشانه در فاز گشایش نیازمند پهنای باند حافظه است، هزینهای بهمراتب بیشتر از خواندن ورودی دارد. رویکرد VocabX با تغییر پرسش اصلی، هزینه و زمان ذخیرهشده توسط هر نشانه را بر اساس بخشهای مختلف مانند پیام سیستم، پیام کاربر یا پاسخ مدل ارزیابی میکند. این روش در دو لایه زیرنشانه و کلاننشانه عمل میکند و با استفاده از کاوشگرهای خودکار، الگوهای تکراری مانند ساختارهای JSON را به نشانههای واحد تبدیل میکند.
بررسیها نشان میدهد روشهای موجود در ادبیات پژوهش، واژهها را بر اساس بسامد انتخاب میکنند نه هزینه، و تنها در یک لایه فعالیت دارند. در مقابل، VocabX با تخمین آماری کاندیداها و استفاده از بودجه مشخص، توانسته است حجم واژهنامه خروجی را کاهش دهد. در آزمایشهای انجامشده روی ارزیاب مقالات با استفاده از پردازنده گرافیکی RTX 5090 و سرور استنتاج vLLM، پاسخ مدل از میانگین ۳۵۰ نشانه به ۱۰۱ نشانه کاهش یافت و هزینه استنتاج ۷۷ درصد افت کرد. همچنین امتیاز کیفی مدل نیز از ۰.۷۰۳ به ۰.۸۱۰ بهبود پیدا کرد.
مقایسه این روش با رویکردهای مرجع دیگر در پنج حوزه عمومی شامل قراردادها، مقالات پزشکی، مقالات علمی، اخبار و کدنویسی پایتون نشان داد که VocabX در تمامی ترکیبها فشردهسازی بیشتری ارائه میدهد. این پژوهش نشان میدهد که شخصیسازی مدلهای زبانی تنها به دادهها و وزنها محدود نمیشود، بلکه میتوان با بهینهسازی لایه واژهنامه در بخش پیش از آموزش، هزینههای استنتاج را در کاربردهای واقعی به شکل محسوسی کاهش داد.
گزارش فارسی این خبر با کمک هوش مصنوعی و فقط بر اساس اطلاعات منتشرشده در منبع تهیه شده است.