
پروفایلینگ TorchNeuron؛ بررسی سیستممحور عملکرد مدلها روی تراشههای AWS Trainium
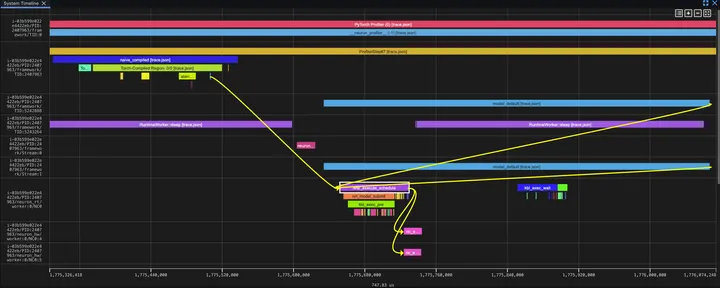
این مقاله آموزشی به بررسی روشهای تحلیل عملکرد استنتاج و شناسایی گلوگاههای پردازشی روی تراشههای هوش مصنوعی AWS Trainium میپردازد. با استفاده از ابزارهای بومی پایتون، توسعهدهندگان میتوانند نحوه اجرای عملیات را در لایههای سختافزاری ردیابی کنند.
بسیاری از متخصصان یادگیری ماشین میدانند چگونه مدلها را سریعتر اجرا کنند، اما تحلیل دقیق علل کندی مدلها نیازمند ابزارهای سیستممحور است. در این گزارش آموزشی، نحوه تحلیل عملکرد استنتاج روی تراشههای AWS Trainium و بکاند بومی آن یعنی TorchNeuron بررسی شده است. این ابزار به توسعهدهندگان اجازه میدهد کارهای استاندارد پایتورچ را با حداقل تغییرات کد روی تراشههای اختصاصی آمازون اجرا کنند.
برای تحلیل عملکرد، ابزارهایی مانند torch.profiler با بکاند Neuron و محیط نمایشی Neuron Explorer به کار گرفته میشوند. این ابزارها امکان ثبت دادههای زمانبندی و مقایسه زمان پردازنده مرکزی با زمان سختافزار Neuron را فراهم میکنند. بررسی عملیاتهایی مانند RMSNorm در حالتهای مختلف نشان میدهد که ادغام عملیاتها (Fusion) تا چه اندازه میتواند تأثیر مثبتی بر کاهش زمان اجرای سختافزاری داشته باشد.
نتایج نشان میدهند که پیادهسازیهای ساده با عملیات مجزا زمان بیشتری روی دستگاه مصرف میکنند، در حالی که توابع ادغامشده یا استفاده از کامپایلر، عملیات را در یک چرخه سختافزاری واحد اجرا کرده و زمان پردازش را به شدت کاهش میدهند. این بررسیها به مهندسان کمک میکند تا نقاط ضعف مدل خود را شناسایی کرده و کارایی اجرای آن را به بالاترین حد برسانند.
گزارش فارسی این خبر با کمک هوش مصنوعی و فقط بر اساس اطلاعات منتشرشده در منبع تهیه شده است.