
مدل جدید هوش مصنوعی Dharma Field Extractor برای استخراج دادههای ساختاریافته معرفی شد
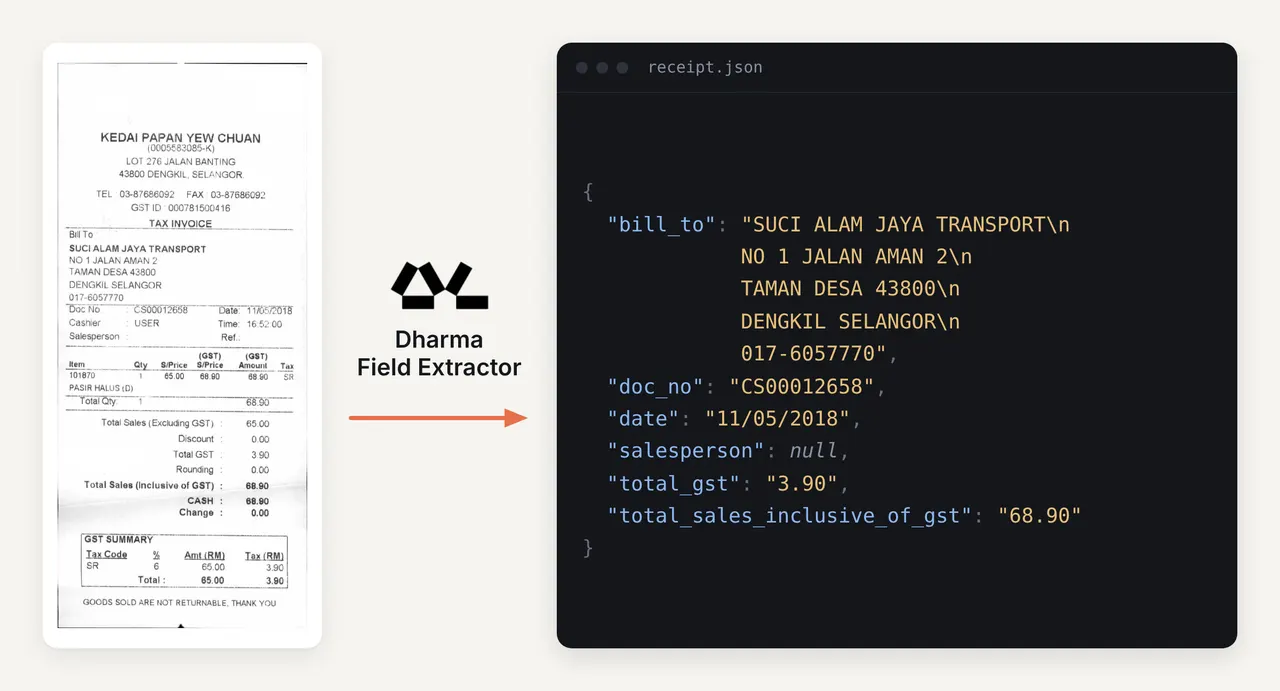
هاگینگ فیس از Dharma Field Extractor رونمایی کرد؛ مدلی با دو میلیارد پارامتر که تصاویر اسناد مختلف را دریافت کرده و خروجی ساختاریافته JSON تحویل میدهد. این ابزار در بنچمارکهای مختلف، مدلهای بزرگ پیشرو را با هزینهای بسیار کمتر شکست داده است.
هاگینگ فیس از مدل جدیدی به نام Dharma Field Extractor رونمایی کرده است که برای استخراج اطلاعات ساختاریافته از اسناد مختلف طراحی شده است. این مدل دو میلیارد پارامتری میتواند تصاویر اسناد را دریافت کرده و خروجی مورد نظر را به شکل ساختاریافته و در قالب JSON تحویل دهد. مدل جدید بر پایه نسخه بهبودیافته DharmaOCR-LITE v1.1 توسعه یافته و با استفاده از آموزشهای تکمیلی روی دادههای انگلیسی، پرتغالی و چندزبانه بهینهسازی شده است.
این ابزار از دو روش درخواست پشتیبانی میکند: حالت باز (Open) که مدل بدون داشتن هیچگونه الگو یا اسکیما، اطلاعات صفحه را خوانده و مفاهیم را به صورت کلید-مقدار استخراج میکند، و حالت مبتنی بر اسکیما (Schema-directed) که کاربر ساختار دقیق، انواع دادهها و نام کلیدهای دلخواه را مشخص میکند تا خروجی دقیقاً مطابق با سیستمهای سازمانی آماده شود. در صورتی که فیلدی در سند وجود نداشته باشد، مدل به جای حدس زدن، مقدار null را برمیگرداند.
در ارزیابیهای انجامشده روی مجموعهای شامل ۵۴۶ سند در سه سناریوی مختلف، این مدل توانست امتیاز F1 بالایی کسب کند و عملکردی فراتر از مدلهای قدرتمند تجاری ارائه دهد. علاوه بر کیفیت بالا، هزینه اجرای این مدل به صورت میزبانی شخصی روی یک پردازنده گرافیکی L40S بسیار پایینتر از تعرفه APIهای عمومی ارزیابی شده است. این دستاورد بار دیگر نشان میدهد که مدلهای کوچک و تخصصی میتوانند در وظایف مشخص، عملکردی به مراتب بهینهتر از مدلهای بزرگ عمومی داشته باشند.
گزارش فارسی این خبر با کمک هوش مصنوعی و فقط بر اساس اطلاعات منتشرشده در منبع تهیه شده است.