
انویدیا سه راهکار برای افزایش ۴۲.۵ درصدی سرعت مدل Ling-3.0-flash روی سیستم DGX Spark معرفی کرد
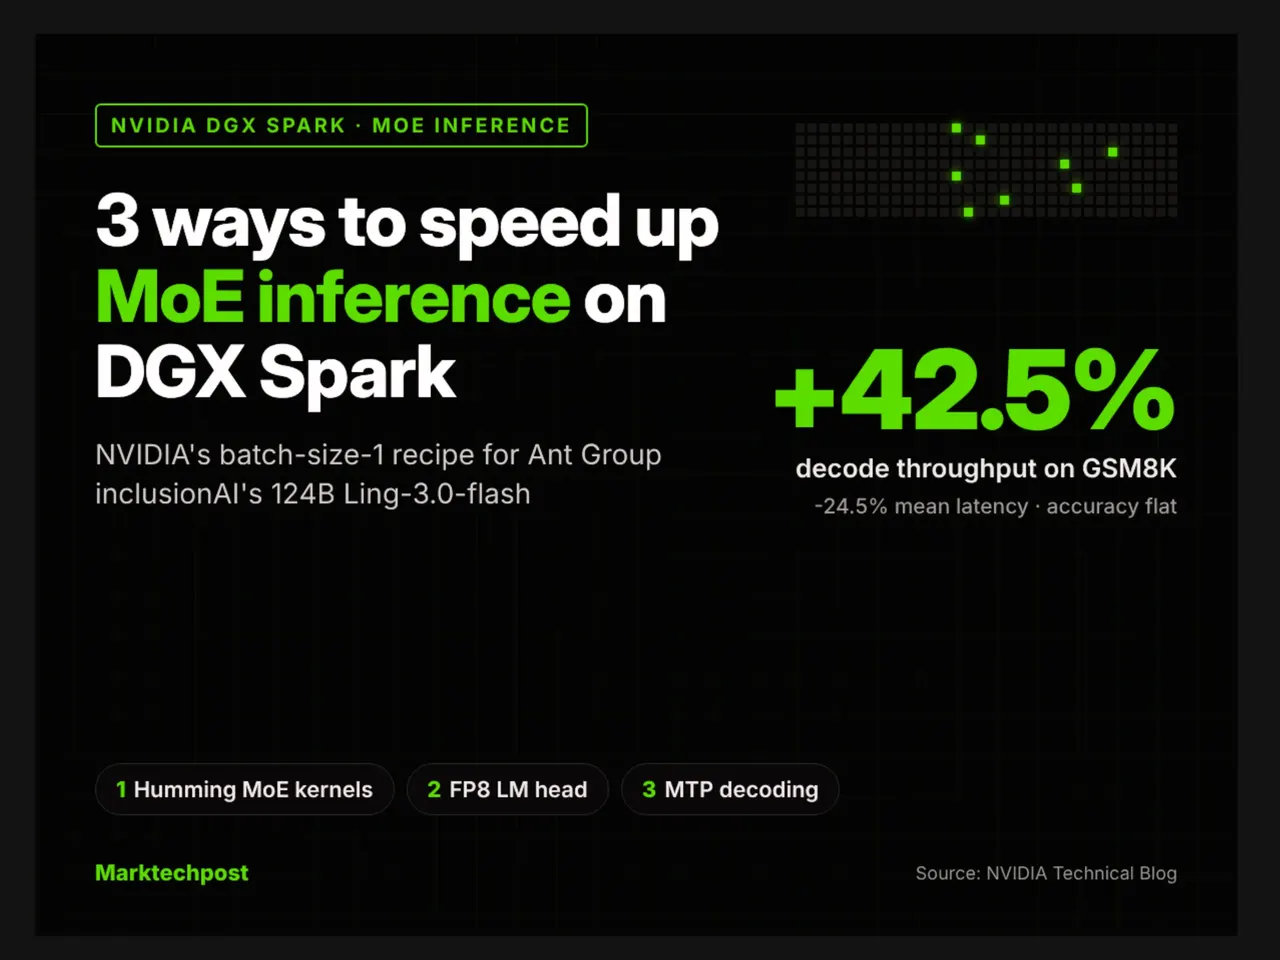
انویدیا با انتشار یک مقاله فنی نشان داد که چگونه با استفاده از سه بهینهسازی شامل هسته جدید MoE، لایه خروجی FP8 و دیکدینگ حدسی داخلی، میتوان سرعت اجرای مدل هوش مصنوعی Ling-3.0-flash را به میزان قابل توجهی افزایش داد.
وبلاگ فنی انویدیا جزئیات جدیدی را درباره نحوه سرعت بخشیدن به استنتاج مدلهای ترکیبی کارشناسان (MoE) روی یک سیستم دسکتاپی DGX Spark منتشر کرده است. مدل مورد استفاده در این آزمایش، Ling-3.0-flash متعلق به گروه انتیکلوسین AI است که یک مدل MoE با ۱۲۴ میلیارد پارامتر کل و ۵.۱ میلیارد پارامتر فعال محسوب میشود. انویدیا با ترکیب سه بهینهسازی شامل یک بکاند هسته جدید MoE، لایه خروجی FP8 و مکانیسم دیکدینگ حدسی داخلی توانست توان عملیاتی رمزگشایی را روی تمامی پرسشهای استاندارد GSM8K بدون افت دقت آماری معنادار تا ۴۲.۵ درصد افزایش دهد.
سیستم DGX Spark یک رایانه دسکتاپی مجهز به تراشه قدرتمند GB10 Grace Blackwell است که ۱۲۸ گیگابایت حافظه یکپارچه ارائه میدهد. بررسیهای انویدیا نشان داد که عملیات رمزگشایی در این مدل به شدت محدود به پهنای باند حافظه است و خواندن وزنهای مدل زمان اجرای دستورات را هدایت میکند. با جایگزینی هستههای استاندارد با کتابخانه مستقل Humming، استفاده از لایه خروجی FP8 برای کاهش حجم خوانشها و به کارگیری قابلیت پیشبینی چندتکهای (MTP)، سرعت تولید توکن به طور چشمگیری بهبود یافت.
آزمایشهای انجام شده روی تمام ۱۳۱۹ پرسش مجموعه داده GSM8K نشان داد که میانگین زمان به ازای هر توکن خروجی کاهش یافته و توان عملیاتی از ۳۷.۸۱ به ۵۳.۸۹ توکن بر ثانیه رسیده است، در حالی که دقت مدل روی عدد ۹۶.۸۲ درصد ثابت باقی مانده است. این دستاوردها نشان میدهد که چگونه توسعهدهندگان میتوانند مدلهای بزرگ هوش مصنوعی را حتی روی سختافزارهای دسکتاپی با بالاترین بهرهوری اجرا کنند.
گزارش فارسی این خبر با کمک هوش مصنوعی و فقط بر اساس اطلاعات منتشرشده در منبع تهیه شده است.