
جهش عملکرد در پردازش داده؛ معرفی الگوریتم جدید e-means متا برای جایگزینی k-means
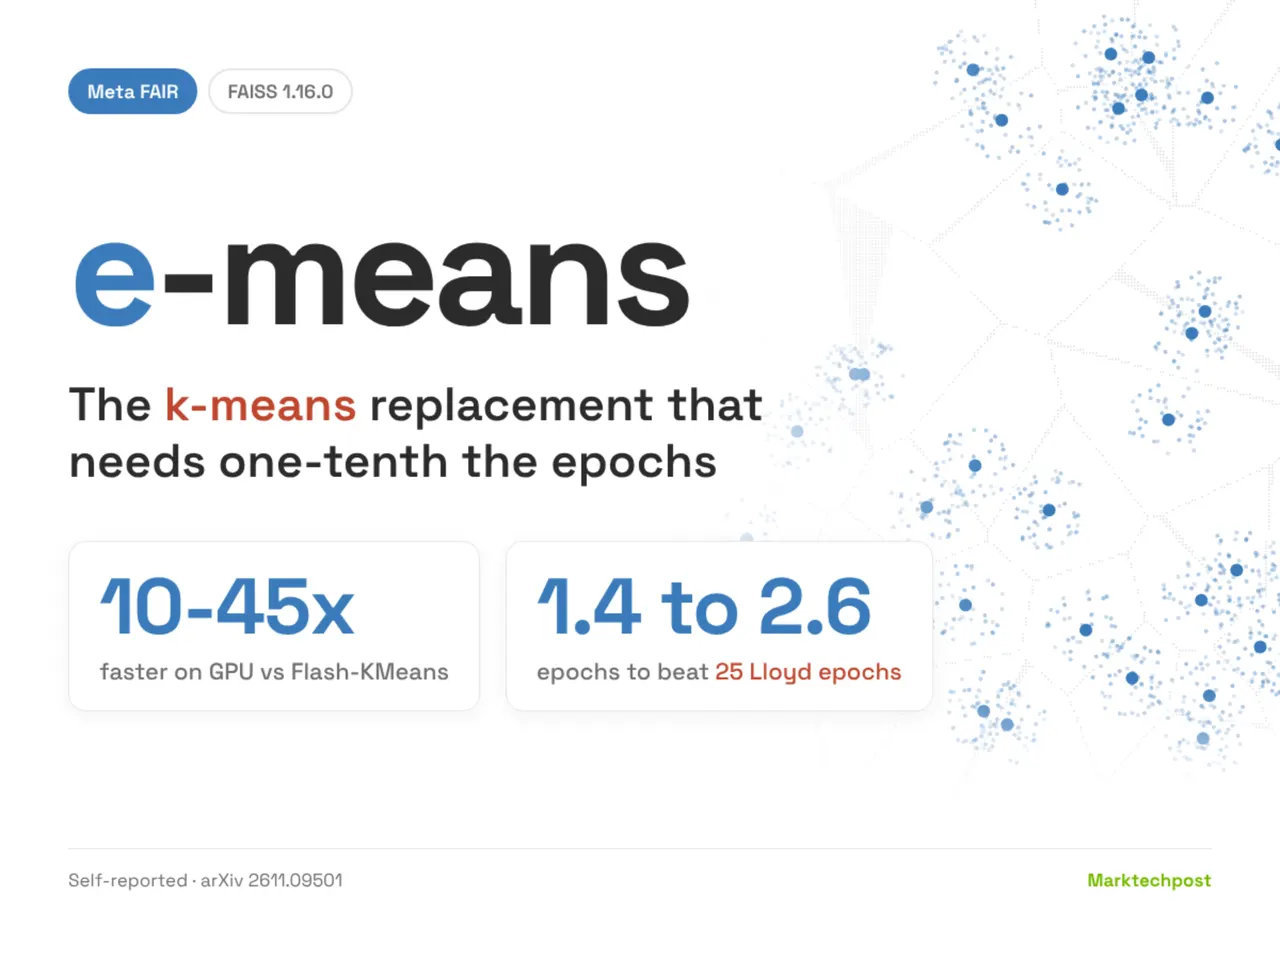
تیم تحقیقاتی FAIR متا با معرفی الگوریتم e-means، تحولی در پردازش خوشهبندی دادهها ایجاد کرده است. این الگوریتم با عملکردی بسیار سریعتر از k-means کلاسیک، اکنون در کتابخانه FAISS 1.16.0 در دسترس قرار دارد.
محققان آزمایشگاه هوش مصنوعی متا (FAIR) از الگوریتم جدیدی با نام e-means رونمایی کردهاند که به عنوان جایگزینی بهینه برای الگوریتم کلاسیک k-means (معروف به Lloyd's k-means) در پردازش دادهها عمل میکند. این الگوریتم جدید، نتایج مشابه با کارهای گذشته را در زمانی بسیار کوتاهتر، تنها با ۱.۴ تا ۲.۶ دور پردازش (Epoch) به جای ۲۵ دور، به دست میآورد. این فناوری اکنون در نسخه ۱.16.0 کتابخانه FAISS در بخش faiss.contrib.e_means گنجانده شده است.
خوشهبندی دادهها، به ویژه در ساخت ایندکسهای برداری و خطوط لوله مدیریت داده، اغلب یکی از کندترین مراحل است. الگوریتم e-means از رویکرد میانگین متحرک نمایی (EMA) استفاده میکند تا به جای محاسبه مجدد کل دادهها در هر مرحله (آنگونه که در روش Lloyd انجام میشود)، آمار خوشهها را بهروزرسانی کند. این تغییر باعث میشود دادههای قدیمیتر به تدریج اثر خود را از دست بدهند و خوشهها با دادههای جدید سازگارتر شوند.
در بنچمارکهای ارائه شده، e-means عملکردی خیرهکننده نشان داده است؛ از جمله کسب ۱۰ تا ۴۵ برابر سرعت بیشتر روی پردازندههای گرافیکی (GPU) نسبت به الگوریتم Flash-KMeans و ۸ تا ۱۵ برابر سرعت بیشتر روی پردازندههای مرکزی (CPU) نسبت به نسخه قبلی FAISS. این دستاورد علاوه بر افزایش سرعت، با استفاده از قوانین مقیاسپذیری، نیاز به تنظیمات پیچیده ابرپارامترها را نیز از بین میبرد و ابزاری قدرتمند برای کسانی است که با حجم عظیمی از دادهها در پروژههای یادگیری ماشین سر و کار دارند.
گزارش فارسی این خبر با کمک هوش مصنوعی و فقط بر اساس اطلاعات منتشرشده در منبع تهیه شده است.
دیدگاهها
دیدگاه شما پس از تأیید مدیر منتشر میشود. گفتوگوی فارسی و انگلیسی این خبر جداست.