
مدل qwenGPU؛ اجرای کدهای واقعی CUDA درون وزنهای مدل Qwen3.5-2B
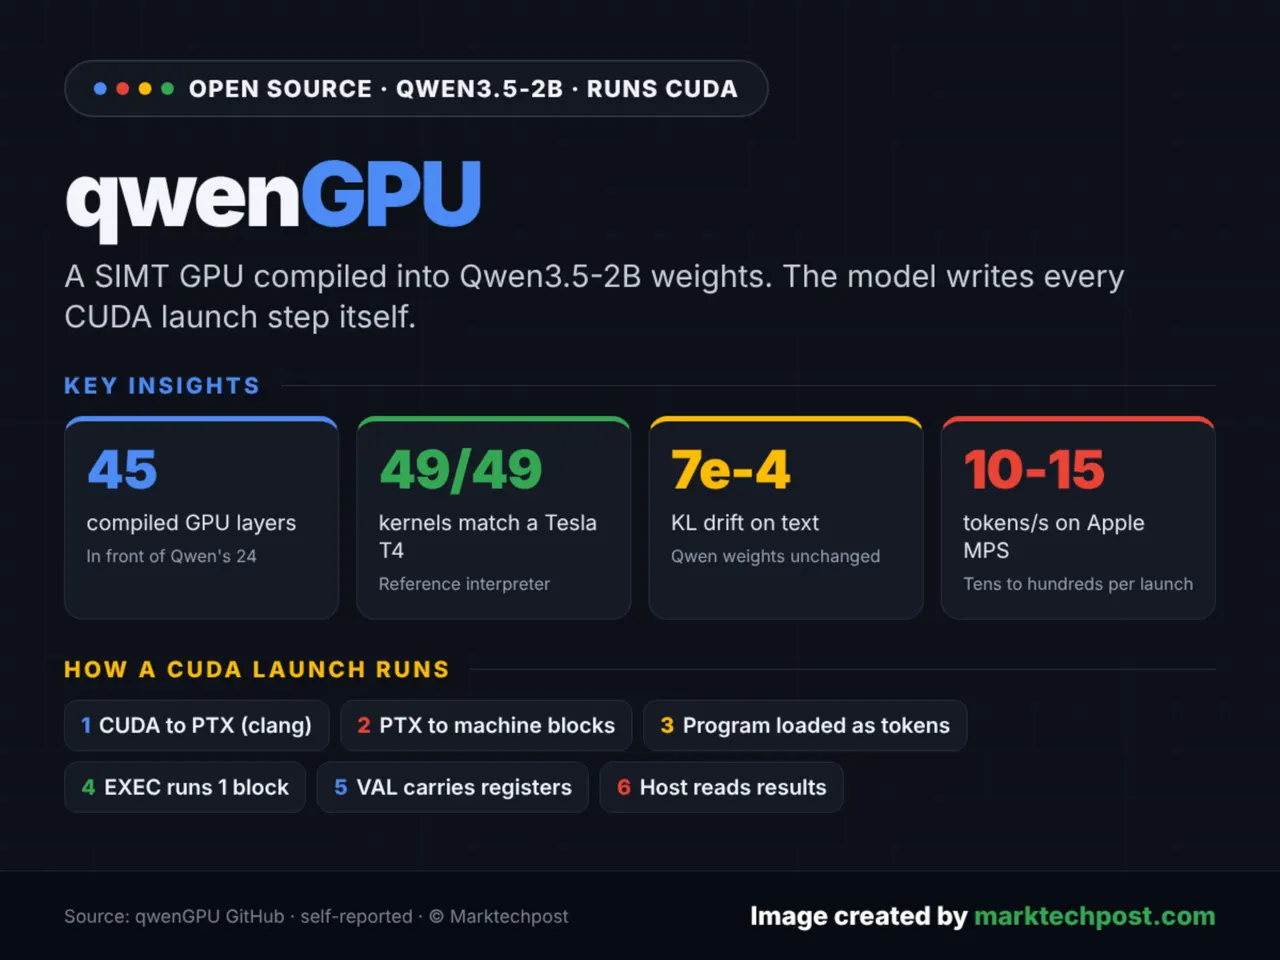
توسعهدهندهای به نام Vixhal مدل تجربی جدیدی به نام qwenGPU را معرفی کرده که یک واحد پردازش گرافیکی (SIMT GPU) را مستقیماً به وزنهای مدل Qwen3.5-2B کامپایل میکند. این مدل شامل ۴۵ لایه کامپایلشده در کنار ۲۴ لایه اصلی است و میتواند کدهای واقعی CUDA را در جریان پردازش خود اجرا کند.
مدل تجربی جدیدی به نام qwenGPU معرفی شده است که یک پردازنده گرافیکی SIMT را مستقیماً درون وزنهای مدل زبانی Qwen3.5-2B کامپایل میکند. این پروژه توسط توسعهدهندهای با نام Vixhal روی گیتهاب و تحت مجوز MIT منتشر شده است و این ایده را آزمایش میکند که محاسبات دقیق میتوانند مستقیماً در درون یک مدل پیشآموزشدیده زبانی انجام شوند، نه در کنار آن.
ساختار این مدل ترکیبی شامل Qwen3.5-2B با ۲۴ لایه به همراه ۴۵ لایه کامپایلشده گرافیکی است که در مجموع به ۶۹ لایه میرسد. برای اجرای آن به حدود ۱۶ گیگابایت حافظه آزاد نیاز است و روی تراشههای اپل سیلیکون، پردازندههای گرافیکی انویدیا یا پردازنده مرکزی اجرا میشود. این سیستم از لایههای نوع Gated DeltaNet و SwiGLU خود مدل Qwen برای ساخت سلولهای حافظه، رجیسترها و حافظه برنامهها استفاده میکند.
در این معماری، میزبان نقش درایور CUDA و کامپایلر را بازی میکند؛ کدهای CUDA را به PTX کامپایل کرده و به عنوان توکن به مدل میدهد. سپس مدل خودش مراحل اجرای دستورات را مینویسد. در بررسیهای انجامشده، مفسر مرجع توانسته است با کارت گرافیک NVIDIA Tesla T4 در تمامی تستهای کرنل مطابقت داشته باشد. با این حال، سرعت اجرای آن روی تراشههای اپل حدود ۱۰ تا ۱۵ توکن بر ثانیه است و این پروژه فعلاً به عنوان یک نسخه نمایشی پژوهشی شناخته میشود تا یک ابزار اجرایی سریع.
گزارش فارسی این خبر با کمک هوش مصنوعی و فقط بر اساس اطلاعات منتشرشده در منبع تهیه شده است.