
چرا مدلهای هوش مصنوعی دچار خطای فکری میشوند؟ یادآوری به عنوان مانع اصلی
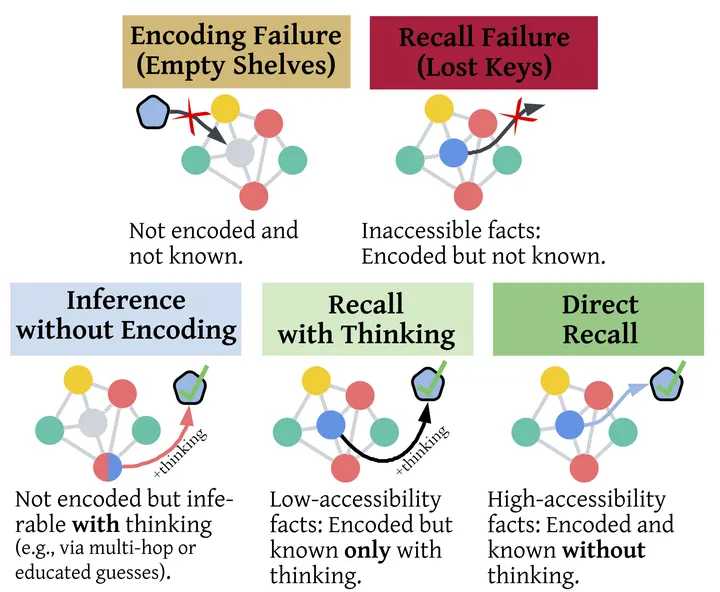
پژوهش جدید گوگل نشان میدهد که مدلهای زبانی بزرگ تقریباً تمام اطلاعات را در خود ذخیره کردهاند، اما مشکل اصلی آنها در بازیابی این دانش است. بررسیها حاکی از آن است که خطاهای فکری ناشی از شکست در یادآوری است تا کمبود اطلاعات.
هنگامی که مدلهای زبانی بزرگ (LLMs) در پاسخ به حقایق دچار اشتباه میشوند، این سؤال مطرح میشود که آیا آنها هرگز آن اطلاعات را یاد نگرفتهاند یا قادر به یادآوری آن نیستند؟ فریمورک جدید گوگل با عنوان پروفایل دانش نشان میدهد که مدلهای پیشرفته تقریباً تمام حقایق را کدگذاری میکنند، اما در یادآوری بسیاری از آنها با مشکل مواجه هستند. این موضوع نشان میدهد که خطاهای فکری بیشتر ناشی از کلیدهای گمشده یا همان شکست در یادآوری است تا قفسههای خالی.
پژوهشگران برای بررسی این موضوع بنچمارک جدیدی به نام WikiProfile معرفی کردند که شامل هزاران حقیقت مشتق شده از ویکیپدیا است. با دستهبندی پروفایلهای دانش، مشخص شد که در مدلهای پیشرفته، کدگذاری حقایق به اشباع نزدیک است، اما بازیابی آنها چنین وضعیتی ندارد. حتی مدلهای مجهز به قابلیت تفکر نیز همچنان درصدی از حقایق را بهطور مستقیم بازیابی نمیکنند، که نشان میدهد تنگنای اصلی از کسب دانش به استفاده از دانش تغییر یافته است.
مقیاسبندی مدلها نشان میدهد که نسخههای بزرگتر مشکلات کمتری در کدگذاری دارند، اما شکست در یادآوری همچنان پابرجا ست. نتایج این تحقیق همچنین به بررسی مسائل مربوط به حقایق نادر و نفرین معکوس پرداخته و نشان میدهد که تفکر میتواند به عنوان مکانیزمی برای تسهیل یادآوری عمل کند. این یافتهها پیشنهاد میکنند که بهبودهای بعدی در صحت اطلاعات ممکن است نه از طریق افزایش مقیاس، بلکه از طریق استفاده بهتر از دانش موجود در مدل به دست آید.
گزارش فارسی این خبر با کمک هوش مصنوعی و فقط بر اساس اطلاعات منتشرشده در منبع تهیه شده است.